LLM, Tokens, RAG… Verstehst du beim Thema KI auch oft nur Bahnhof?
LLM, Tokens, RAG, Embeddings, Kontextfenster: Rund um KI begegnen uns immer mehr Fachbegriffe. In dieser Serie versuche ich, die wichtigsten Begriffe verständlich zu erklären.
Wer sich etwas intensiver mit ChatGPT, Copilot, Claude oder anderen KI-Systemen beschäftigt, kennt das vermutlich:
Plötzlich tauchen überall Begriffe wie LLM, Tokens, RAG, Embeddings, Kontextfenster oder Reasoning auf.
Und schnell entsteht der Eindruck, man müsse erst Informatik studieren, bevor man überhaupt versteht, was da passiert.
Dabei sind viele dieser Konzepte erstaunlich einfach.
Beginnen wir mit drei Begriffen, die einem heute besonders häufig begegnen.
1. Was ist ein LLM?
LLM steht für Large Language Model, auf Deutsch ungefähr: grosses Sprachmodell.
Wenn wir heute im Zusammenhang mit ChatGPT, Claude, Gemini und Co. von KI sprechen, steckt dahinter sehr häufig ein solches LLM.
Wichtig ist aber die Unterscheidung: ChatGPT selbst ist beispielsweise nicht einfach «das LLM». ChatGPT ist eine Anwendung, die KI-Modelle und weitere Funktionen zusammenbringt. Das LLM ist dabei vereinfacht gesagt der Sprachmotor im Hintergrund.
Ein LLM wurde mit sehr grossen Mengen an Text trainiert und hat dabei Muster und Zusammenhänge in Sprache gelernt.
Die Grundidee ist überraschend einfach: Das Modell versucht vorherzusagen, welcher Textbaustein als Nächstes passen könnte.
Ein bisschen wie die Wortvorschläge auf dem Handy
Wenn du auf deinem Smartphone schreibst:
«Heute scheint die …»
wird dir ziemlich wahrscheinlich etwas wie «Sonne» vorgeschlagen.
Das Handy versucht abzuschätzen, welches Wort sinnvoll folgen könnte. Ein LLM macht vereinfacht gesagt etwas Ähnliches – nur in einer völlig anderen Grössenordnung.
Es berücksichtigt viel mehr Zusammenhänge und kann dadurch erstaunlich komplexe Antworten erzeugen. Moderne Modelle können Texte zusammenfassen, übersetzen, programmieren, Informationen strukturieren und komplexe Aufgaben bearbeiten.
Ein LLM ist vereinfacht gesagt eine extrem leistungsfähige Maschine, die mit erstaunlicher Genauigkeit vorhersagt, wie Text sinnvoll weitergehen könnte.
Und genau das erklärt auch eine seiner grössten Schwächen: Ein Sprachmodell kann eine Antwort erzeugen, die vollkommen überzeugend klingt – und trotzdem falsch ist.
Denn es schlägt nicht automatisch jede Aussage in einer verlässlichen Wissensdatenbank nach. Es erzeugt zunächst eine Antwort, die aufgrund der gelernten Zusammenhänge gut passt.
2. Was sind Tokens?
Hier wird es oft unnötig technisch.
Ein Token ist zunächst einfach ein kleiner Textbaustein.
Denn ein Sprachmodell verarbeitet unseren Text nicht genau so, wie wir Menschen ihn lesen.
Für uns ist beispielsweise:
«Die Katze sitzt auf dem Sofa.»
ein Satz mit sechs Wörtern.
Das Modell zerlegt diesen Text jedoch zuerst in kleinere Bausteine. Ein Token kann dabei ein ganzes Wort sein, aber auch nur ein Teil eines Wortes, ein Satzzeichen oder eine andere Zeichenfolge.
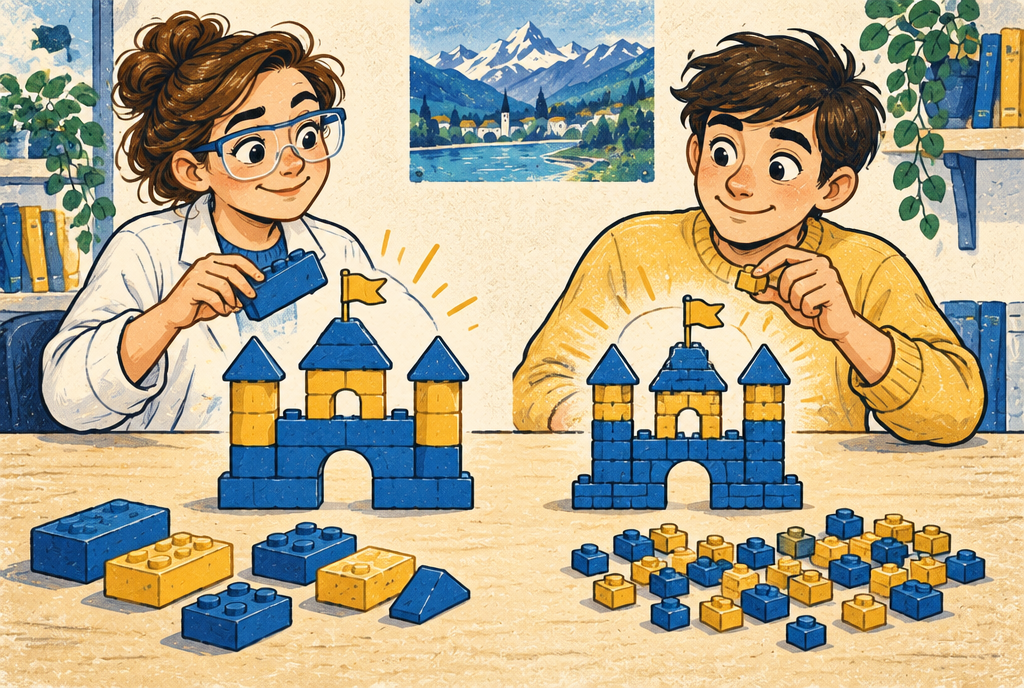
Stell dir eine Lego-Burg vor
Angenommen, zwei Personen sollen dieselbe Burg aus Bausteinen bauen.
Die erste Person verwendet vor allem grosse Steine. Die zweite Person hat kleinere Steine und benötigt deshalb deutlich mehr davon.
Am Ende sieht die Burg trotzdem praktisch gleich aus.
Bei Tokens ist es ähnlich. Der ursprüngliche Text bleibt derselbe, aber unterschiedliche Modelle können ihn in unterschiedlich grosse Bausteine zerlegen.
Ein Wort kann bei einem Modell vielleicht aus einem Token bestehen und bei einem anderen aus mehreren.
Der Text bleibt gleich. Nur die Bausteine können unterschiedlich sein.
Deshalb lässt sich auch nicht einfach sagen: Ein Wort entspricht einem Token.
Warum sollte mich das interessieren?
Weil Tokens an mehreren Stellen wichtig sind. Sie bestimmen mit, wie viel Text ein Modell gleichzeitig verarbeiten kann, wie viele Informationen in einen Prompt passen und bei vielen KI-Diensten auch, wie die Nutzung verrechnet wird.
Man begegnet deshalb häufig Angaben wie:
128’000 Tokens Kontext
Und damit kommen wir gleich zum nächsten Begriff, der häufig zusammen mit Tokens auftaucht.
Was ist ein Kontextfenster?
Das Kontextfenster beschreibt vereinfacht gesagt, wie viel Information das Modell bei einer Aufgabe gleichzeitig berücksichtigen kann.
Stell dir einen Schreibtisch vor
Auf diesem Schreibtisch liegen deine aktuelle Frage, vorherige Nachrichten, eine PDF, eine Anleitung und vielleicht noch einige Notizen.
Solange alles auf den Tisch passt, kann die KI diese Informationen bei ihrer Antwort berücksichtigen. Aber der Tisch ist nicht unendlich gross. Irgendwann ist er voll.
Das Kontextfenster bestimmt also gewissermassen die Grösse dieses Schreibtisches. Und die Tokens sind die einzelnen Textbausteine, die wir darauflegen.
Tokens sind die Bausteine. Das Kontextfenster bestimmt, wie viele davon gleichzeitig Platz haben.
3. Und was bedeutet RAG?
RAG steht für Retrieval-Augmented Generation.
Das klingt erheblich komplizierter, als das Konzept tatsächlich ist.
Ein Sprachmodell beantwortet deine Frage zunächst mit dem Wissen und den Informationen, die ihm gerade zur Verfügung stehen.
Bei RAG kommt vorher noch ein zusätzlicher Schritt hinzu: Das System sucht zuerst nach passenden Informationen in einer externen Quelle und gibt diese anschliessend zusammen mit deiner Frage an das Sprachmodell weiter.
Das können beispielsweise interne Firmenunterlagen, Bedienungsanleitungen, technische Dokumentationen, Richtlinien, Produktdaten oder Datenbanken sein.
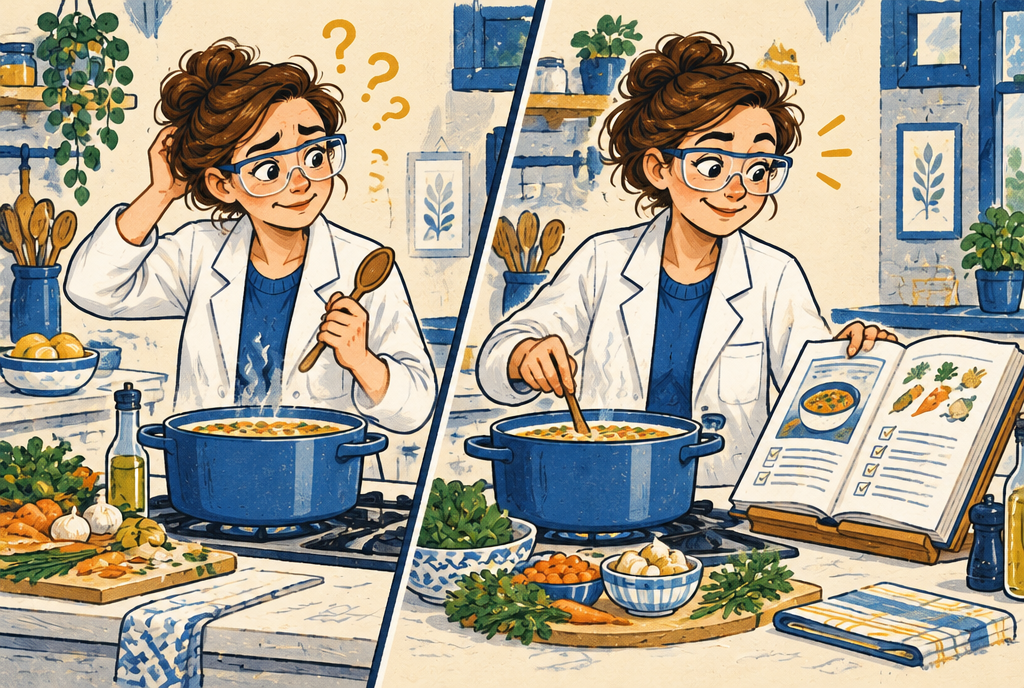
Stell dir einen Koch vor
Ein guter Koch kann auch ohne Rezept kochen. Er kennt viele Gerichte, Zutaten und Zubereitungsarten aus Erfahrung.
Aber jetzt soll er ein ganz bestimmtes Gericht exakt nach einem bestimmten Rezept zubereiten.
Ohne Rezept muss er sich auf sein Wissen und seine Erinnerung verlassen. Mit Rezept kann er nachschauen: Welche Zutaten brauche ich? Wie viel davon? In welcher Reihenfolge? Wie lange muss etwas in den Ofen?
Genau diese zusätzliche Informationsquelle ist die Idee hinter RAG.
Das LLM kann kochen. RAG gibt ihm das passende Rezept zum Nachschlagen.
In der Realität ist dieses «Rezept» natürlich kein Kochbuch. Es kann beispielsweise eine Bedienungsanleitung, ein Firmenhandbuch, eine technische Dokumentation oder eine Datenbank sein.
Warum Firmen so oft über RAG sprechen
Damit wird auch verständlich, weshalb RAG gerade im Unternehmensumfeld so interessant ist.
Ein öffentliches Sprachmodell kennt nicht automatisch die internen Arbeitsanweisungen eines Unternehmens, die aktuelle technische Dokumentation, eine gestern geänderte Richtlinie oder den Inhalt eines internen Projektdossiers.
Mit einem passenden RAG-System könnte eine Anfrage beispielsweise lauten:
«Welche Vorgaben gelten bei uns für diese Arbeit?»
Das System sucht dann zuerst in den dafür freigegebenen internen Unterlagen nach den relevanten Informationen.
Das Sprachmodell bekommt diese Dokumentenausschnitte als zusätzlichen Kontext und formuliert daraus die Antwort.
RAG macht eine KI allerdings nicht automatisch fehlerfrei.
Wenn die Suche die falschen Dokumente findet, die Daten veraltet sind oder das Modell die gefundenen Informationen falsch interpretiert, kann auch eine RAG-Antwort falsch sein. Die Qualität der Quellen und der Suche bleibt deshalb entscheidend.
Und was hat das alles mit meinem Prompt zu tun?
Mehr, als man zunächst denkt.
Ein Prompt ist zunächst nichts anderes als die Anweisung, die wir der KI geben.
Und hier passiert genau dasselbe wie bei jeder anderen Kommunikation: Die andere Seite kann nicht sehen, was wir im Kopf haben.
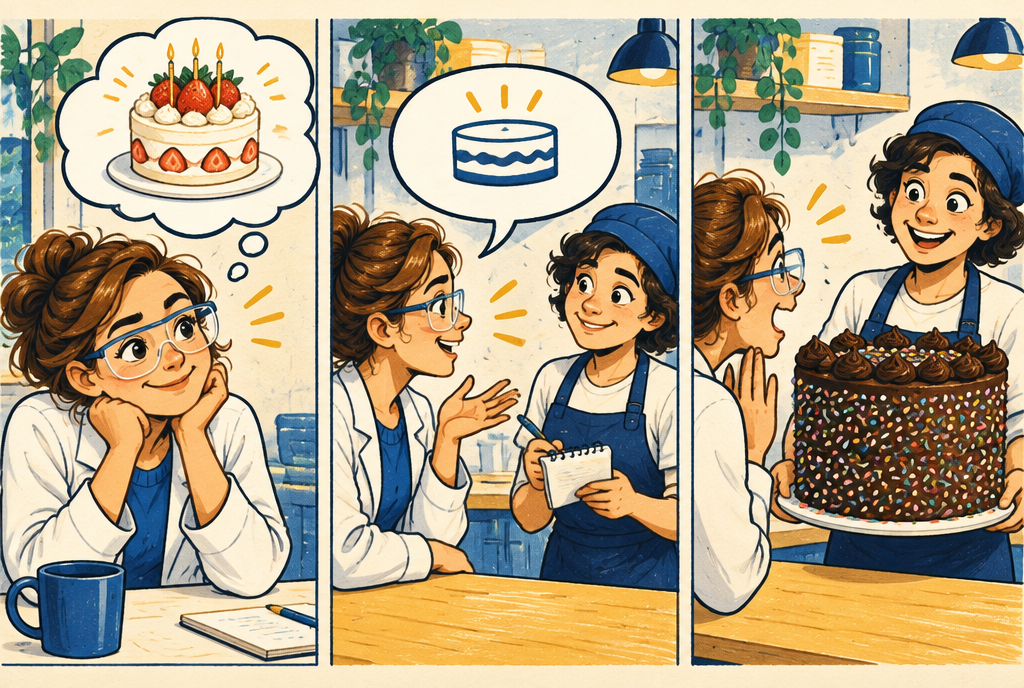
«Mach mir einen schönen Kuchen»
Stell dir vor, ich habe in meinem Kopf eine ganz bestimmte Vorstellung: eine kleine, elegante Geburtstagstorte mit Erdbeeren.
Ich sage aber nur:
«Mach mir einen schönen Kuchen.»
Mein Gegenüber hat nun eine völlig andere Vorstellung von «schön» und bringt vielleicht eine riesige Schokoladentorte mit bunten Streuseln.
Die Aufgabe wurde erfüllt. Ich habe einen schönen Kuchen bekommen. Nur eben nicht den Kuchen, den ich im Kopf hatte.
Und genau das passiert auch bei KI erstaunlich oft.
Wir schreiben:
«Schreib mir eine gute Antwort.»
In unserem Kopf haben wir dabei vielleicht bereits eine klare Vorstellung: kurz, freundlich, für einen Kunden, ohne Fachbegriffe und maximal fünf Sätze.
Nur haben wir der KI davon nichts gesagt.
Ein besserer Prompt wäre deshalb:
«Schreib eine kurze Antwort für einen Kunden. Er kennt das technische Thema nicht. Erkläre den Sachverhalt ohne Fachbegriffe und beschränke dich auf etwa fünf Sätze.»
Jetzt liegen beide Vorstellungen viel näher beieinander.
Das Problem ist dabei nicht unbedingt, dass die KI unsere erste Anweisung «falsch verstanden» hat. Wir haben einfach nicht gesagt, was wir tatsächlich wollten.
Eine der wichtigsten Regeln beim Umgang mit KI ist deshalb:
Was für mich selbstverständlich ist, weiss mein Gegenüber noch lange nicht.
Fünf Begriffe, fünf einfache Bilder
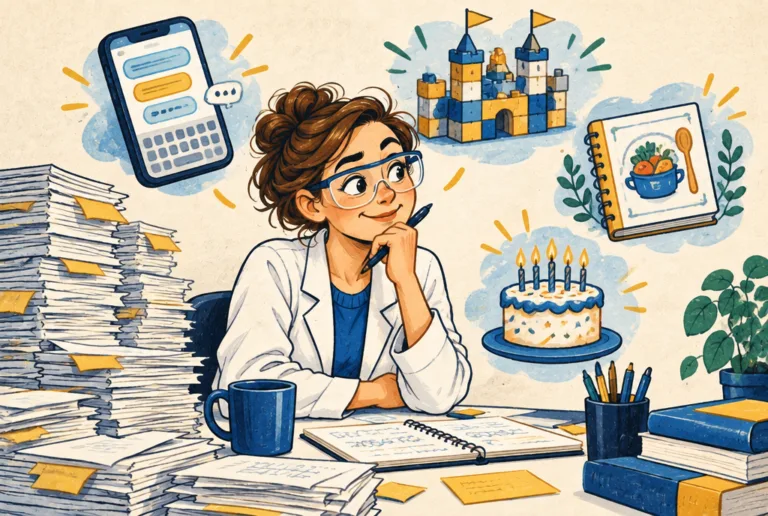
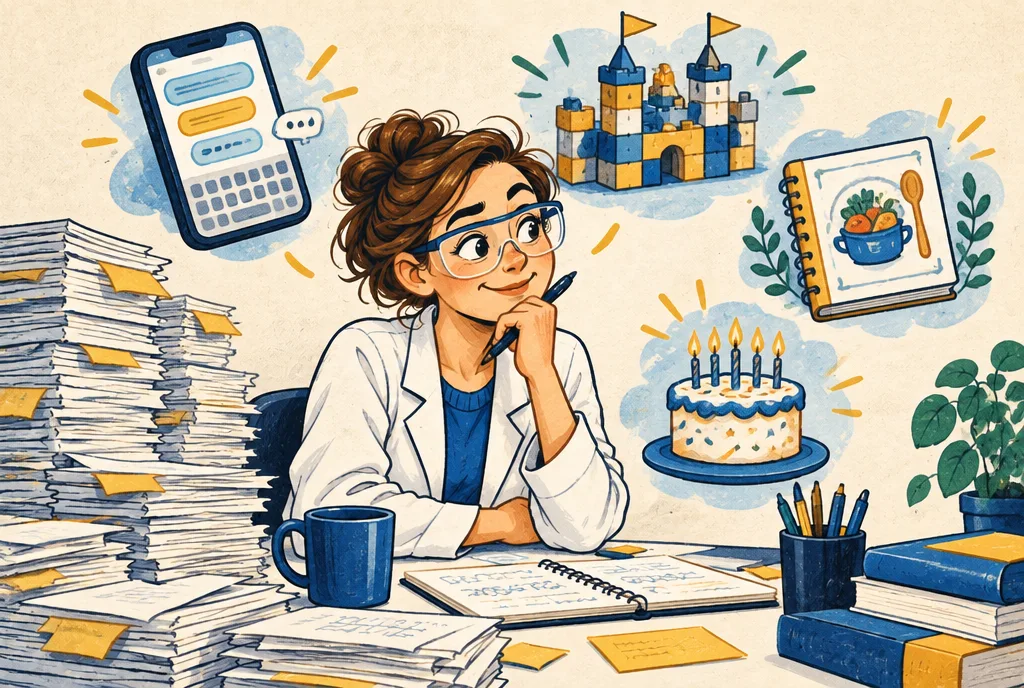
LLM – die Wortergänzung: Wie die Wortvorschläge auf dem Smartphone – nur unglaublich viel leistungsfähiger.
Tokens – die Bausteine: Text wird in kleine Teile zerlegt. Je nach Modell können diese unterschiedlich gross sein.
Kontextfenster – der Schreibtisch: Alles, was die KI bei einer Aufgabe berücksichtigen soll, muss gewissermassen auf diesen Tisch passen.
RAG – der Koch mit Rezeptbuch: Das LLM besitzt allgemeines Wissen. Mit RAG darf es zusätzlich in passenden Unterlagen nachschlagen.
Prompt – «Mach mir einen schönen Kuchen»: Die KI kennt das Bild in meinem Kopf nicht. Je genauer ich beschreibe, was ich möchte, desto grösser ist die Chance, dass wir am Ende vom Gleichen sprechen.
Mein Fazit
Das grösste Hindernis beim Einstieg in KI ist aus meiner Sicht oft gar nicht die Technik.
Es ist die Sprache rundherum.
Viele Begriffe klingen nach komplizierter Informatik, obwohl sich die Grundidee dahinter oft mit einem Smartphone, ein paar Bausteinen, einem Schreibtisch, einem Rezeptbuch oder einem Kuchen erklären lässt.
Und man muss auch nicht jede technische Einzelheit kennen, um KI sinnvoll einzusetzen.
Entscheidend ist zu verstehen, was das Werkzeug grundsätzlich macht – und wo seine Grenzen liegen.
Genau deshalb soll dieser Beitrag auch nicht der letzte dieser Art sein.
Begriffe wie Embeddings, Reasoning, Fine-Tuning, KI-Agent oder MCP klingen heute vielleicht noch ähnlich kompliziert. Schauen wir mal, ob wir auch dafür Bilder finden, die ohne Informatikstudium funktionieren.
Mein Brain.exe braucht jedenfalls keine hundert neuen Abkürzungen gleichzeitig. Drei oder fünf sauber verstandene Begriffe sind mir lieber als dreissig, die ich irgendwann schon einmal gehört habe.
FENTRAX