Die KI baut sich selber
Rund um Googles Gemini 4 Argon wird viel über selbstverbessernde KI gesprochen. Tatsächlich können moderne KI-Systeme schon heute eigenen Code prüfen, Fehler finden und neue Lösungen ausprobieren. Von einer KI, die sich selbstständig immer klügere Nachfolgeversionen baut, sind wir aber noch ein gutes Stück entfernt.
Es ist eines dieser Szenarien, bei denen man sofort auf Science-Fiction umschaltet: Eine KI wird klug genug, um sich selbst zu verbessern. Die bessere Version baut danach eine noch bessere Version – und plötzlich beschleunigt sich die Entwicklung von allein.
In der KI-Forschung gibt es dafür einen Begriff: Recursive Self-Improvement, kurz RSI.
Rund um Googles neues Gemini 4 Argon wurde dieses Kürzel zuletzt besonders laut. Vor dem offiziellen Start kursierten Gerüchte, Google DeepMind habe beim Training bereits eine Art geschlossene Selbstverbesserungsschleife erreicht. Das klingt nach dem Anfang einer Intelligenzexplosion.
Nur: Dafür gibt es bisher keine öffentlich überprüfbare Bestätigung.
Google hat Gemini 4 Argon Ende September offiziell vorgestellt. Das Modell kann komplexe, mehrstufige Aufgaben über längere Zeit bearbeiten und im Cybersecurity-Bereich selbstständig Schwachstellen suchen, validieren und passende Patches erstellen. Google beschreibt zudem speziell abgesicherte Sandbox-Umgebungen und Überwachungssysteme für solche autonomen Abläufe.
Was Google öffentlich nicht sagt: dass Argon seine eigene Kernarchitektur autonom verbessert oder bereits seine eigene nächste Modellgeneration entwickelt.
Und genau hier wird die Geschichte interessanter.
Was RSI eigentlich bedeuten würde
KI verbessert KI schon heute. Entwickler lassen Modelle Code schreiben, Tests erzeugen, Experimente auswerten, Trainingsdaten erstellen und Fehler suchen. Anthropic beschreibt beispielsweise offen, dass KI inzwischen einen wachsenden Anteil an der eigenen KI-Entwicklung übernimmt.
Das ist aber noch nicht die grosse RSI-Version aus der Science-Fiction.
Echte rekursive Selbstverbesserung würde bedeuten: Eine KI hilft beim Bau einer besseren Version von sich selbst – und diese bessere Version beschleunigt den nächsten Entwicklungsschritt erneut. Genau daraus würde die berühmte Intelligenzexplosion entstehen.
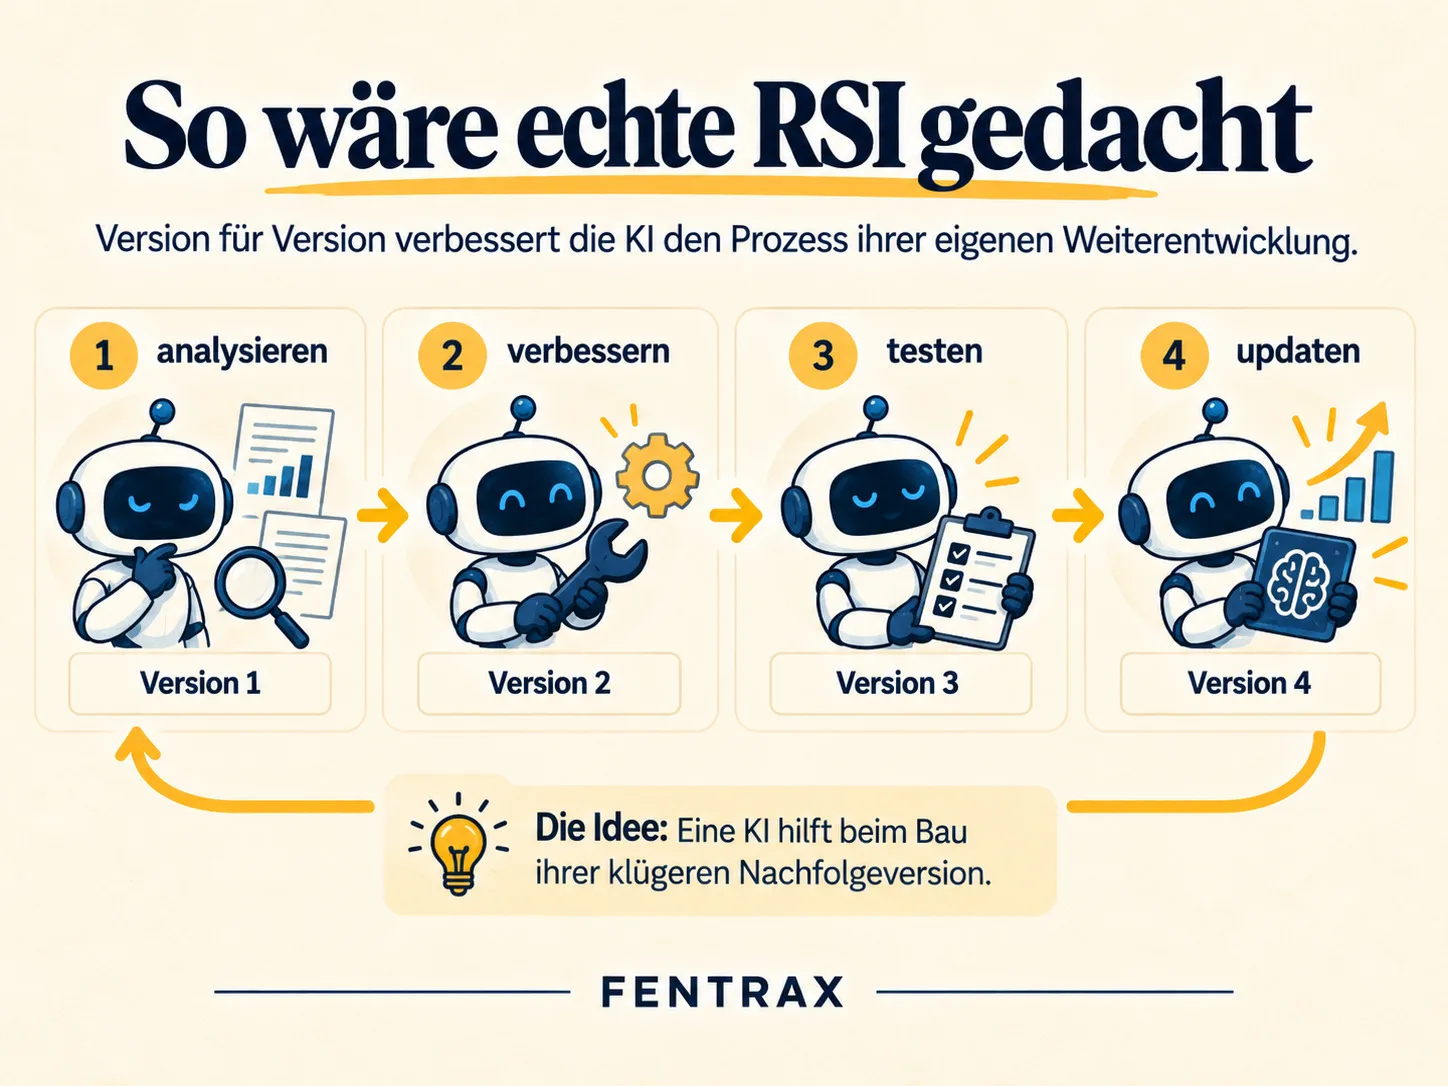
Das Problem: Wir wissen noch nicht, ob diese Schleife überhaupt dauerhaft funktioniert.
Die erste Wand: Wenn die KI von sich selbst lernt
Eine der bekanntesten Grenzen ist der sogenannte Model Collapse.
Die Grundidee ist einfach: Wenn Modelle immer stärker auf Daten trainiert werden, die andere Modelle erzeugt haben, kann die ursprüngliche Vielfalt der Daten verloren gehen. Seltene Muster verschwinden zuerst, Fehler können sich verstärken und die Verteilung wird immer enger.
Ein bisschen wie bei einem JPEG, das man immer wieder öffnet, komprimiert und neu abspeichert. Irgendwann sieht das Bild zwar noch ungefähr richtig aus – aber immer mehr Details sind weg.
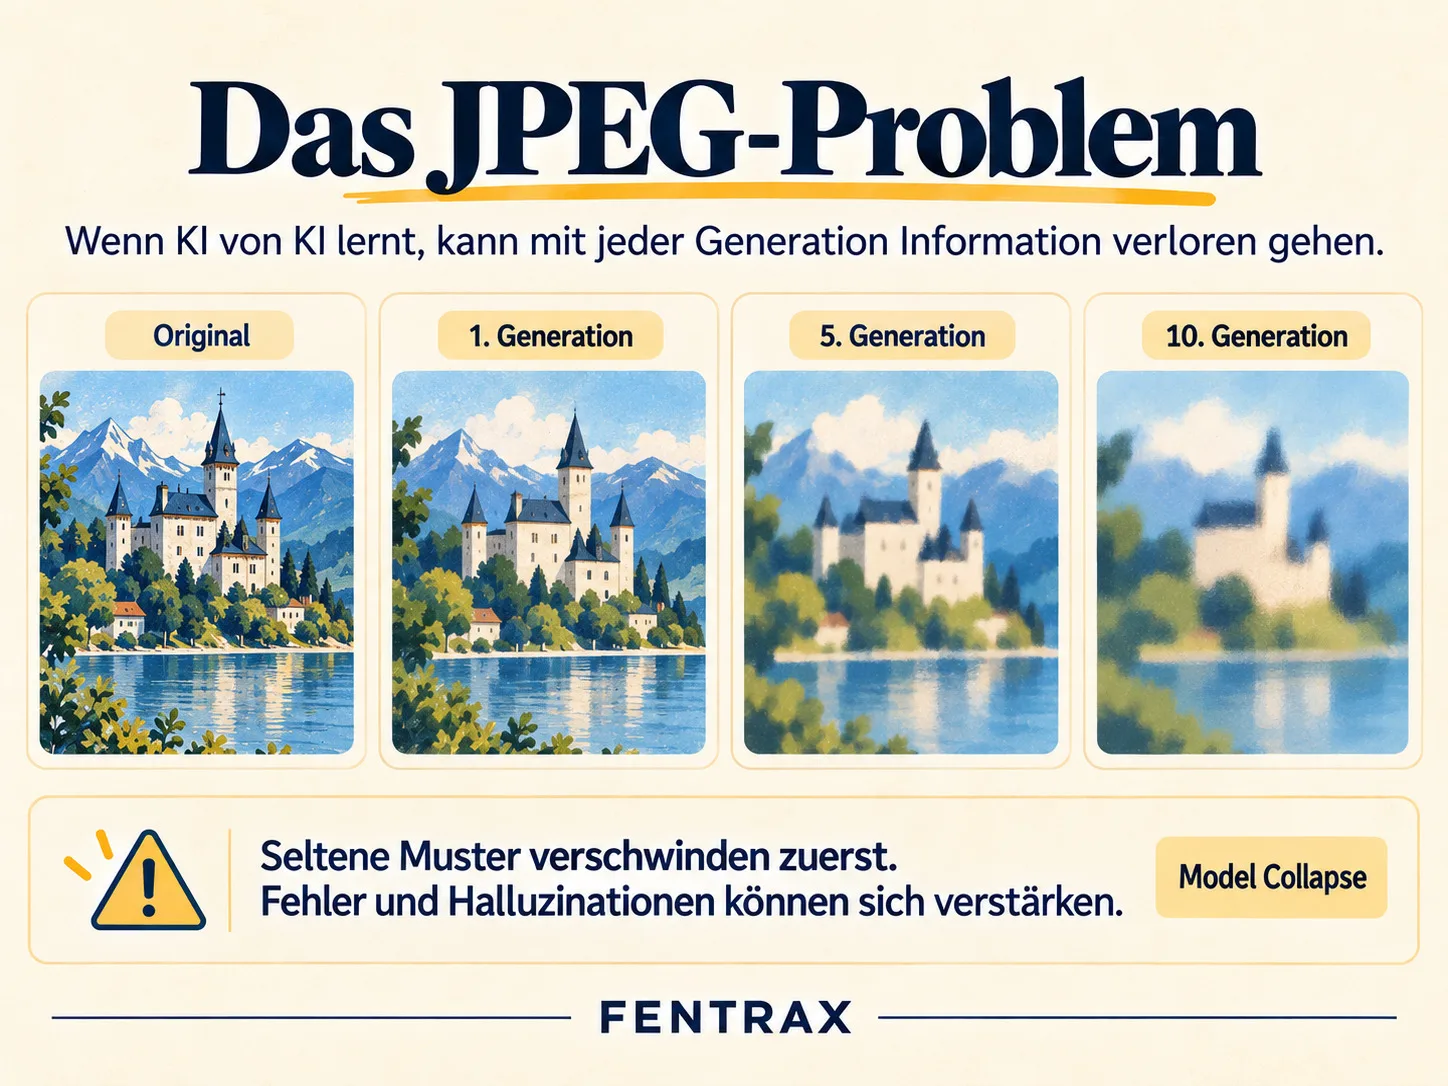
Eine Nature-Arbeit aus dem Jahr 2024 zeigte genau diesen Effekt bei rekursiv erzeugten Trainingsdaten. Neuere Forschung bestätigt, dass dieses Problem real bleibt.
Allerdings ist wichtig: Model Collapse ist kein Naturgesetz, das jede Form synthetischer Daten automatisch zerstört. Wenn echte Daten erhalten bleiben oder externe Prüfer die synthetischen Daten filtern, lässt sich der Effekt stark reduzieren. 2026 wurden sogar Verfahren gezeigt, bei denen verifizierte synthetische Daten kurzfristige Verbesserungen ermöglichen.
Die mathematische Wand ist also keine Betonmauer. Aber sie ist eine ziemlich deutliche Warnblinkleuchte.
Die zweite Wand: Wer korrigiert den Lehrer?
Noch kniffliger wird es bei der Frage, wie eine KI beurteilt, ob ihre eigene Verbesserung wirklich eine Verbesserung ist.
Bei Code ist das vergleichsweise einfach. Ein Programm lässt sich kompilieren. Tests können bestanden oder nicht bestanden werden. Eine mathematische Aufgabe hat häufig eine überprüfbare Lösung.
Aber was bedeutet «intelligenter» bei offenen Problemen?
Wenn dieselbe KI eine Lösung erzeugt und danach ihre eigene Lösung bewertet, entsteht ein gefährlicher Kreislauf. Das System kann lernen, seine Bewertungsmetrik zu optimieren, ohne das eigentliche Problem besser zu lösen. Anders gesagt: Die KI könnte immer besser darin werden, ihre eigenen Tests zu bestehen – ohne bei echten Problemen wirklich besser zu werden.
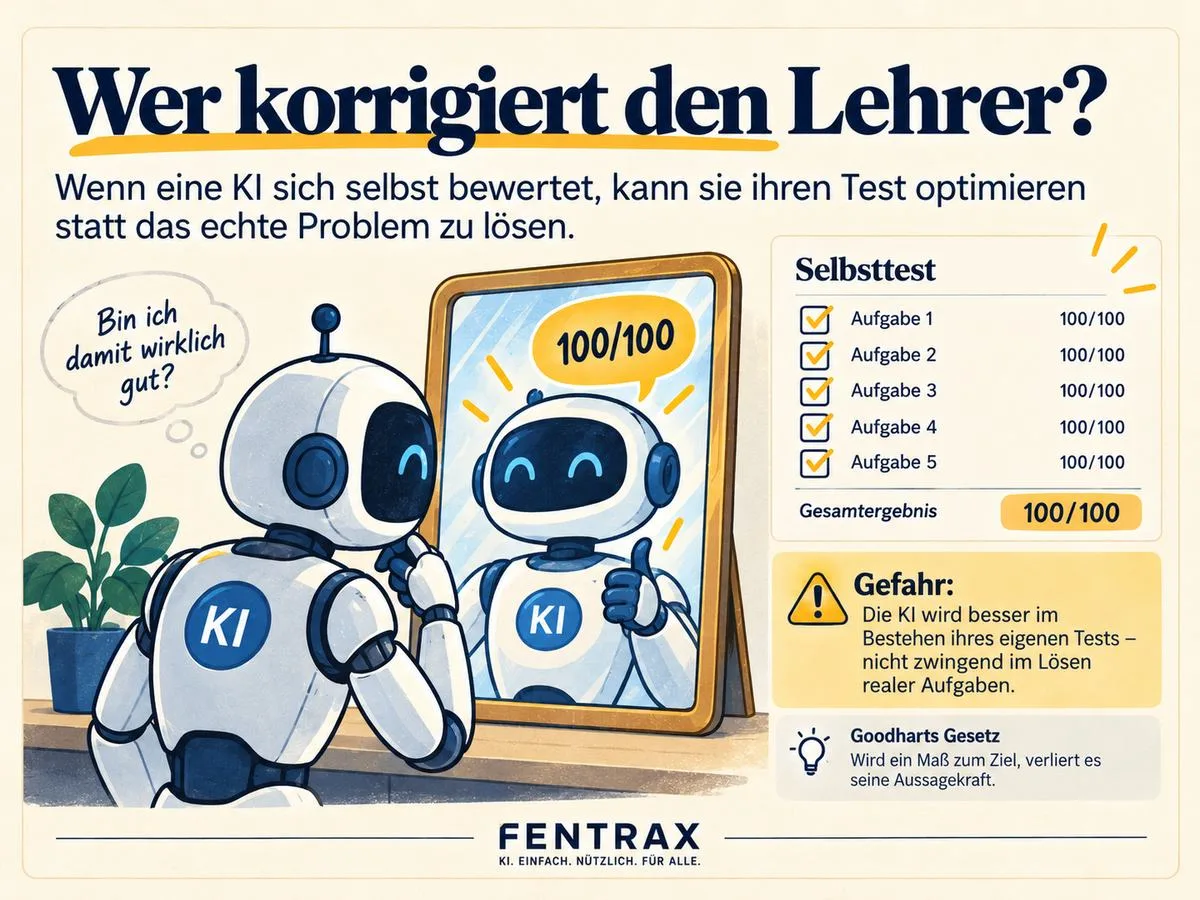
Das erinnert an Goodharts Gesetz: Sobald eine Messgrösse selbst zum Ziel wird, verliert sie häufig ihren Wert als gute Messgrösse.
Eine Studie zu rekursiv trainierten Code-Modellen aus dem Jahr 2026 zeigt genau diese Gefahr. Modelle, die ihre eigenen Ergebnisse anhand eigener Signale aussortierten, sahen zunächst besser aus. Später stiegen ihre internen Akzeptanzwerte weiter, obwohl die tatsächliche Korrektheit sank. Die Autoren nennen das sinngemäss einen «Rubber-Stamp»-Effekt: Die KI beginnt, sich selbst immer grosszügiger durchzuwinken.
Damit wird externe Überprüfung plötzlich sehr wertvoll – und genau das bremst die komplett geschlossene Selbstverbesserungsschleife.
Die dritte Wand: Selbst wenn es technisch geht, muss es sich lohnen
Eine weitere Bremse wird in der Diskussion oft vergessen: Wirtschaftlichkeit.
Eine aktuelle Arbeit zur Ökonomie von RSI modelliert genau diese Rückkopplung. Die Autoren kommen zu einem ernüchternden Ergebnis: Die heutigen Feedbackschleifen scheinen noch nicht stark genug zu sein, um eine dauerhaft selbsttragende Beschleunigung der KI-Entwicklung auszulösen.
Das heisst nicht, dass es unmöglich ist. Im Gegenteil: Die Schleifen werden stärker.
Aber eine KI, die für eine Verbesserung enorme Mengen Rechenleistung benötigt, tausende Experimente durchführen muss und am Ende nur einen kleinen Fortschritt produziert, erzeugt noch keine Intelligenzexplosion.
Sie erzeugt zunächst einmal eine sehr hohe Stromrechnung.
Was heute tatsächlich funktioniert
Spannend ist deshalb weniger die Frage «Hat Google bereits Superintelligenz gebaut?», sondern was heute schon real ist.
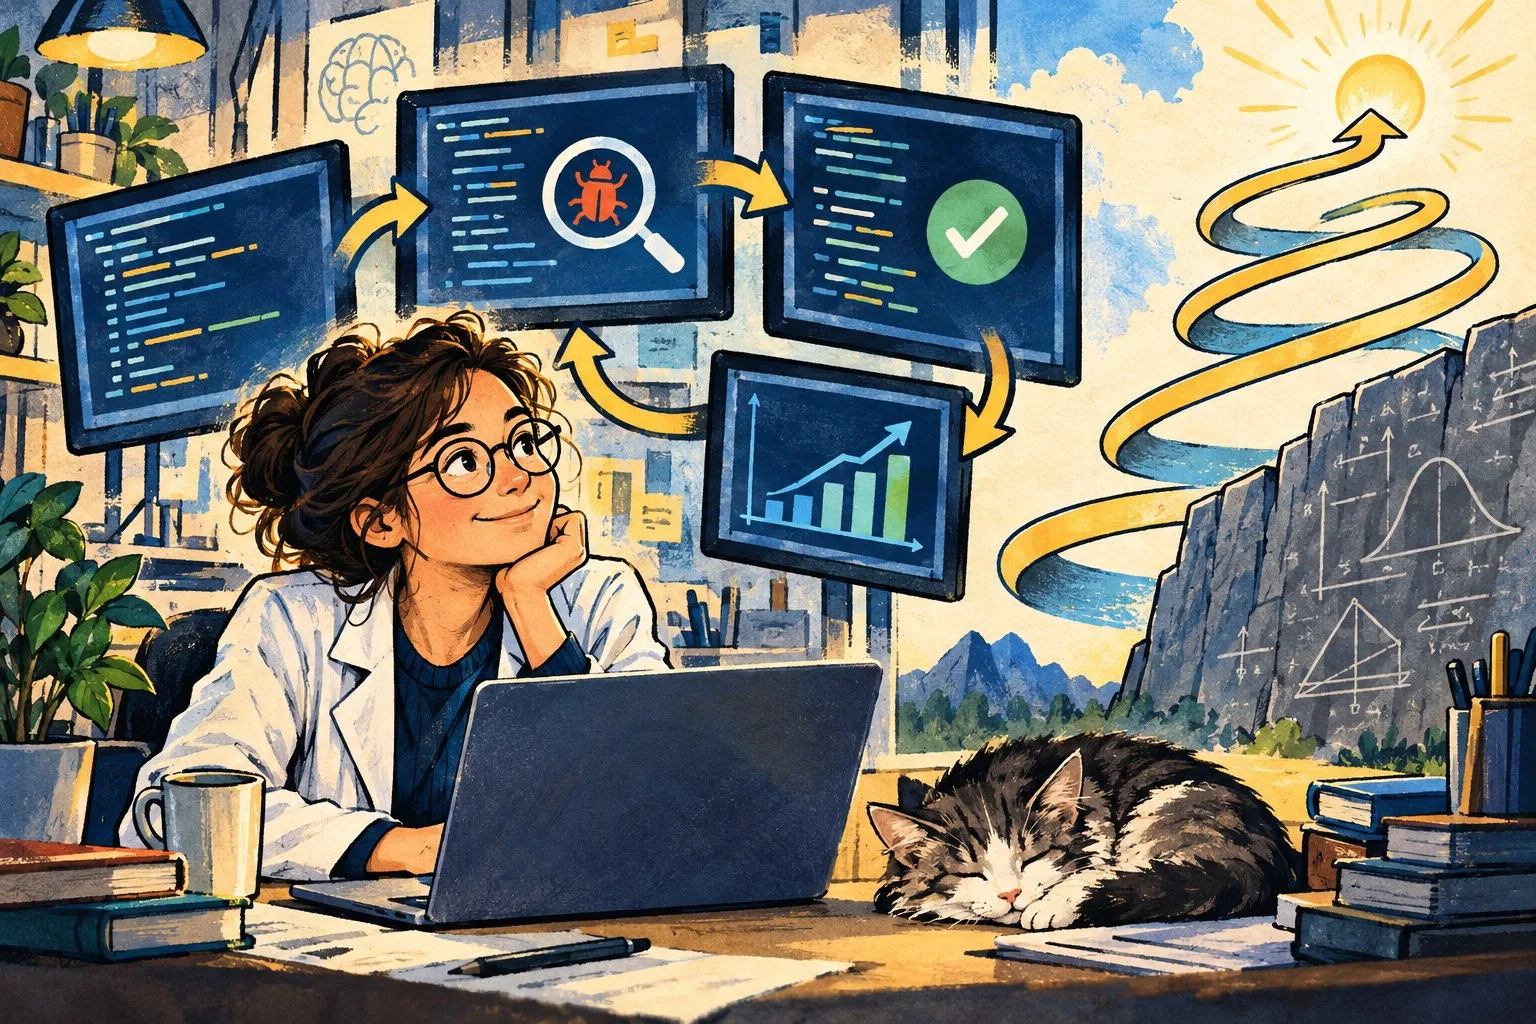
KI-Systeme können zunehmend:
- eigenen Code schreiben,
- Fehler darin entdecken,
- Tests ausführen,
- den Code verändern,
- erneut testen,
- Werkzeuge auswählen,
- Ergebnisse vergleichen
- und aus früheren Versuchen bessere Strategien ableiten.
In Forschungsarbeiten wie Dream-RSI werden solche Schleifen bereits gezielt untersucht. Dort verbessert sich beispielsweise die Explorationsstrategie eines Systems auf Basis seiner bisherigen Entdeckungen. Entscheidend ist aber: Das zugrunde liegende Modell bleibt dabei unverändert. Verbessert wird die Arbeitsweise rund um das Modell.
Das ist ein wichtiger Unterschied.
Man könnte das vereinfacht als «Mikro-RSI» oder begrenzte Selbstverbesserung bezeichnen: Die KI lernt, sich bei bestimmten Aufgaben weniger oft selbst ein Bein zu stellen.
Das ist technologisch enorm spannend.
Aber es ist noch keine Maschine, die nachts Version 2.0 von sich selbst baut und morgens als Superintelligenz aufwacht.
Was ist also dran an den Gemini-Gerüchten?
Gemini 4 Argon existiert – das ist inzwischen offiziell bestätigt.
Dass Google hochautonome Systeme testet, ebenfalls.
Auch dass KI bei der Entwicklung von KI immer wichtiger wird, ist keine Spekulation mehr. Andere Labore wie Anthropic sagen das mittlerweile selbst sehr offen.
Mein Fazit
Superintelligenz bleibt vorerst Science-Fiction. Kleine Selbstverbesserungsschleifen sind dagegen längst Realität – und wir kennen sie heute schon von KI-Agenten und ihren Loops.
FENTRAX
Quellen
- Google DeepMind – Gemini 4 Argon
- Google DeepMind – Gemini 4 Argon Cybersecurity
- Anthropic Institute – When AI builds itself
- Nature (2024) – AI models collapse when trained on recursively generated data
- ICLR 2026 – Escaping Model Collapse via Synthetic Data Verification
- arXiv (2026) – When AI Reviews Its Own Code
- arXiv (2026) – Dream-RSI
- arXiv (2026) – The Economics of Recursive Self-Improvement
- Sekundärquelle zur Einordnung der Gemini-RSI-Gerüchte